Tag: LoRA
Distilling Reasoning: Can Smaller LLMs Learn Chain-of-Thought?
Oppdag hvordan små språkmodeller kan mestre kompleks resonnering gjennom Chain-of-Thought distillering. Vi ser på teknikkene, kostnadene og fallgrubene.
Read More
Instruksjonstilpassing for store språkmodeller: Slik lager du bedre assistenter
Lær hvordan instruksjonstilpassing gjør store språkmodeller om til pålitelige assistenter. Oppdag fordelene med LoRA, dataeffektivitet og hvordan du unngår vanlige fallgruver.
Read More
Benchmark Transfer Etter Fine-Tuning: Slik Generaliserer LLM-er På Tvers av Oppgaver
Lær hvordan LLM-er beholder generell kunnskap etter finjustering. Vi utforsker benchmark transfer, LoRA og strategier mot katastrofal glemming for bedre generalisering.
Read More
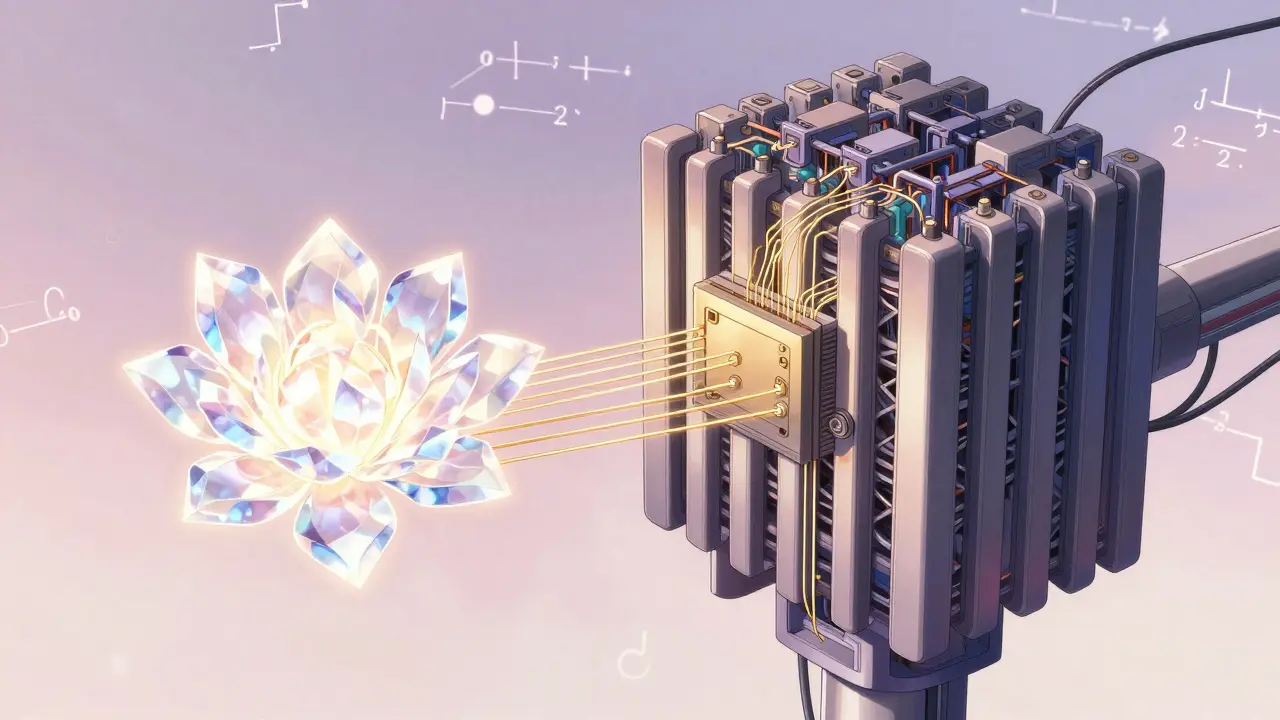
Adapter-lag og LoRA for effektiv tilpasning av store språkmodeller
LoRA og adapter-lag lar deg tilpasse store språkmodeller med bare 1% av minnet. Lær hvordan disse teknikkene fungerer, når du skal velge dem, og hvordan du kommer i gang med en RTX 4090.
Read More